
Dein Team hat Monate in Inhalte gesteckt. FAQ-Blöcke, saubere Antwortabsätze, Interviews mit den eigenen Expert:innen. In der Google-Suche läuft es ordentlich. Trotzdem taucht die Marke in ChatGPT, Perplexity oder den AI Overviews so gut wie... » weiterlesen
 Autor:in
Anna Imhof
Du kannst dir 121WATT-Inhalte in der Google-Suche jetzt bevorzugt anzeigen lassen.
Dein Team hat Monate in Inhalte gesteckt. FAQ-Blöcke, saubere Antwortabsätze, Interviews mit den eigenen Expert:innen. In der Google-Suche läuft es ordentlich. Trotzdem taucht die Marke in ChatGPT, Perplexity oder den AI Overviews so gut wie nie als Quelle auf. Bevor du jetzt noch mehr Content produzierst, lohnt sich der Blick auf die Ebene darunter: Kann ein KI-Bot deine Seiten überhaupt abrufen, laden und lesen? Die folgenden vier Checks kannst du der Reihe nach abarbeiten. Jeder besteht aus Problem, Auswirkung, Test und Maßnahme.
Eine Zahl kursiert derzeit in vielen Vorträgen: Die Überschneidung zwischen den in AI Overviews zitierten Seiten und den organischen Top 10 sei von 76 auf 38 Prozent gefallen. Beide Werte stammen vom selben Anbieter. Die erste Untersuchung von Juli 2025 wertete 1,9 Millionen Zitationen aus einer Million AI Overviews aus und betrachtete dabei die drei sichtbarsten Quellen je Antwort. Ergebnis: gut 76 Prozent der zitierten Seiten rankten in den Top 10. Die Folgeuntersuchung von Anfang 2026 umfasste 863.000 Keywords und vier Millionen AI-Overview-URLs und kam auf 38 Prozent, bei ausschließlicher Betrachtung organischer Treffer auf 37 Prozent. Die übrigen Zitationen verteilen sich fast gleichmäßig auf die Positionen 11 bis 100 und auf Seiten jenseits von Position 100.
Der direkte Vergleich hat allerdings einen Haken. Das Parsing wurde seit der ersten Erhebung verbessert, es werden also mehr Zitationen erkannt als vorher. Beide Datensätze sind damit nicht direkt vergleichbar, ein Teil des Rückgangs kann auf die bessere Erkennung zurückgehen. Markt und Sprache der untersuchten Suchanfragen werden in den Veröffentlichungen nicht aufgeschlüsselt, die Übertragbarkeit auf deutschsprachige Suchanfragen ist also nicht belegt. Nimm die Zahlen deshalb als Richtungsanzeige, nicht als Messgröße. Als Erklärung wird unter anderem die Query-Fan-out-Technik angeführt, die auch Google für AI Overviews und den AI Mode dokumentiert: Zu einer Anfrage werden mehrere verwandte Suchen über Teilthemen ausgespielt, aus deren Ergebnissen die Antwort entsteht. Was unverändert gilt: Wer technisch nicht erreichbar oder nicht lesbar ist, taucht in keiner dieser Auswertungen auf.
Problem: Der Zugriff wird an drei Stellen gesteuert, von denen im Marketing meist nur eine sichtbar ist: robots.txt, Server-Konfiguration und die Einstellungen bei CDN oder Web Application Firewall. Dazu kommen zwei angekündigte Änderungen bei Cloudflare zum 15. September 2026. Erstens gelten für alle Domains, die ab diesem Datum neu zu Cloudflare kommen, neue Voreinstellungen: Bots der Kategorien Training und Agent werden auf Seiten mit Werbeauslieferung blockiert, Search bleibt erlaubt. Zweitens, und das ist der wichtige Punkt für Bestandskunden: Gemischt genutzte Crawler werden ab diesem Datum nach allen ihren Verhaltensweisen behandelt.
Auswirkung auf die KI-Sichtbarkeit: Sind Such- und Retrieval-Bots ausgesperrt, sinkt die Wahrscheinlichkeit deutlich, dass deine Inhalte als Quelle verwendet werden. Vollständig verschwinden musst du deshalb nicht: Nach den Publisher-FAQ von OpenAI können Links und Seitentitel unter bestimmten Umständen auch dann erscheinen, wenn der Crawler blockiert ist. Was fehlt, ist der Inhalt, aus dem zitiert wird. Google selbst führt in seiner Dokumentation zu den AI-Features als erste Grundlage auf, dass Crawling in der robots.txt und in der CDN- oder Hosting-Infrastruktur erlaubt sein muss.
Test: robots.txt prüfen, CDN- und WAF-Einstellungen im Dashboard ansehen, bei Cloudflare zusätzlich die Sicherheitseinstellungen zu AI-Bot-Policies, und die Server-Logs auf 403- und 429-Antworten je User-Agent filtern.
Maßnahme: Triff je Bot-Kategorie eine bewusste Entscheidung und halte sie schriftlich fest.
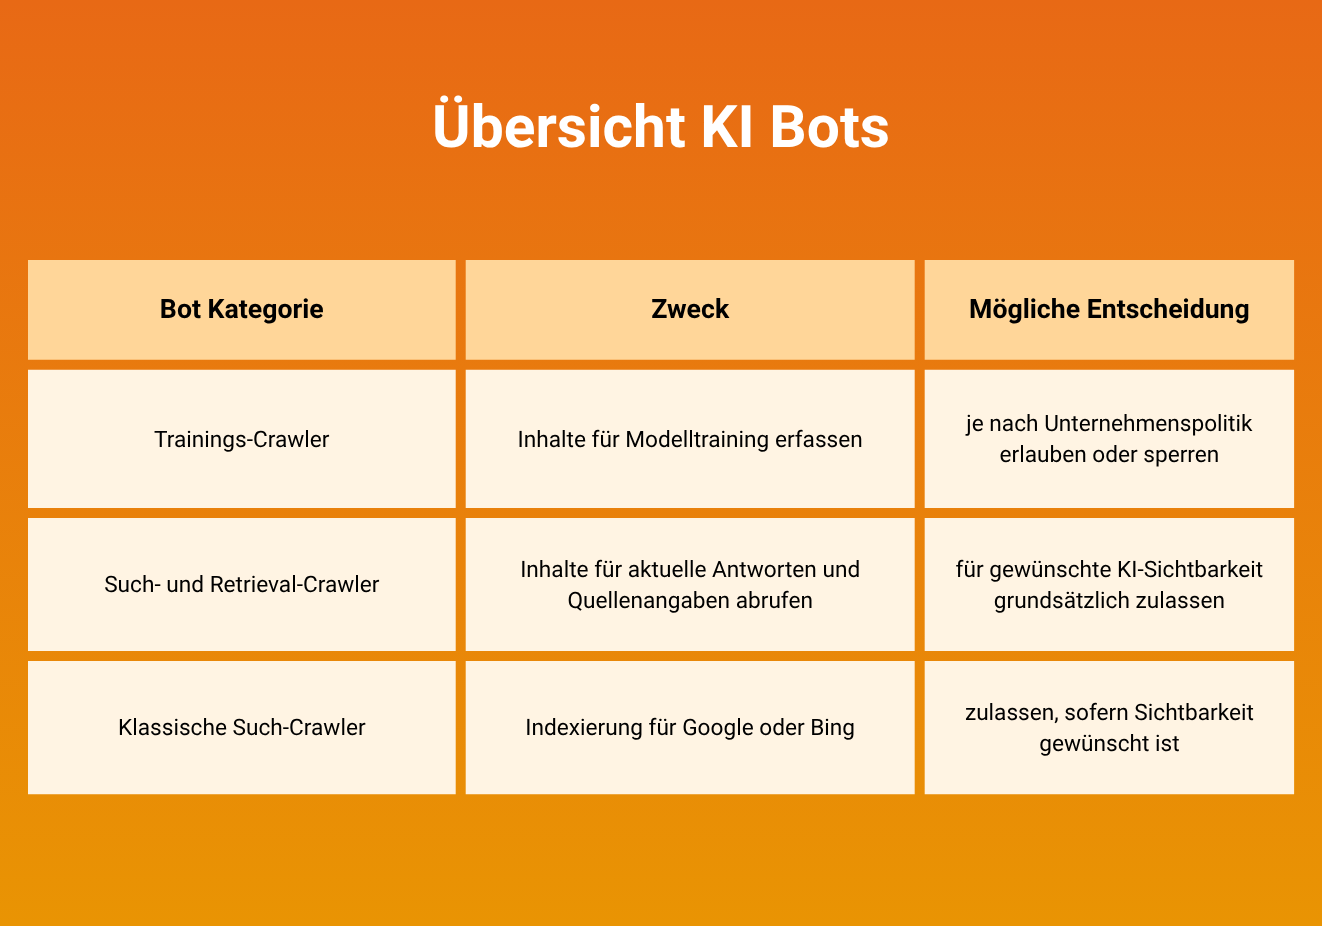
Nach den offiziellen Dokumentationen trennt OpenAI in GPTBot für das Training, OAI-SearchBot für die Suche und ChatGPT-User für nutzerausgelöste Abrufe, dazu kommt OAI-AdsBot für die Prüfung von Anzeigen-Landingpages. Anthropic unterscheidet ClaudeBot, Claude-SearchBot und Claude-User, Perplexity nutzt PerplexityBot und Perplexity-User. Entscheidend für deine Regeln: Das Sperren des Trainings-Bots sperrt den Such-Bot desselben Anbieters nicht mit. Und bei nutzerausgelösten Abrufen weichen die Anbieter voneinander ab. Anthropic gibt an, dass alle drei Bots die robots.txt befolgen, OpenAI und Perplexity weisen darauf hin, dass das für ihre nutzerausgelösten Agenten nicht zwingend gilt. Prüf die Namen vor der Umsetzung noch einmal in der Herstellerdokumentation, die Listen ändern sich mehrmals im Jahr.
Problem: Bei mehreren relevanten KI-Crawlern solltest du nicht davon ausgehen, dass sie clientseitig erzeugte Inhalte zuverlässig rendern. Die belastbarste öffentliche Untersuchung dazu ist eine Server-Log-Analyse von Vercel und MERJ, die dafür sowohl Next.js-Anwendungen als auch Websites mit anderen Technologie-Stacks ausgewertet hat und bei keinem der großen KI-Crawler eine JavaScript-Ausführung feststellen konnte. Allein für den GPTBot wurden dabei über 500 Millionen Abrufe betrachtet, ohne einen einzigen Fall von JavaScript-Ausführung, gleiches galt für die Crawler von Anthropic, Perplexity, Meta und ByteDance. Wichtig für die Einordnung: Diese Analyse stammt aus Dezember 2024, und die Anbieter bestätigen ihr Rendering-Verhalten nicht offiziell. Behandle es als gut belegte Arbeitshypothese, nicht als Naturgesetz.
Sauber trennen solltest du außerdem zwei Dinge, die gerne vermischt werden. Google dokumentiert das Rendering für den Googlebot, Microsoft entsprechend für den Bingbot. Daraus folgt nicht, dass jedes KI-Produkt, das auf diesen Suchindexdaten aufsetzt, beim eigenen Abruf dieselbe Rendering-Infrastruktur nutzt. Dokumentiert ist das Rendering für den jeweiligen Such-Crawler, nicht pauschal für alle darauf aufbauenden KI-Anwendungen.
Auswirkung auf die KI-Sichtbarkeit: Alles, was ohne JavaScript fehlt, ist für nicht rendernde Crawler potenziell unsichtbar und sollte genauer geprüft werden. Heikel ist das vor allem, weil deine Google-Sichtbarkeit dabei unauffällig bleiben kann. Die Seite rankt, der Traffic stimmt, und trotzdem fehlt der zitierbare Text.
Test: JavaScript im Browser abschalten und die wichtigsten Seiten aufrufen. Das ist eine Erstdiagnose, kein Beweis. Ergänze deshalb: Quelltext beziehungsweise Server-Response direkt ansehen, gezielt nach zentralen Überschriften, Haupttext und internen Links im initialen HTML suchen, den Abruf mit einem relevanten User-Agent testen und in den Server-Logs kontrollieren, ob die Bots erfolgreiche Zugriffe mit Statuscode 200 bekommen.
Maßnahme: Zentrale Inhalte gehören ins initiale HTML. Wo das ohne JavaScript nicht geht, übernehmen Server-Side-Rendering, statische Generierung oder Pre-Rendering diese Aufgabe.
Antwortet der Server schnell und zuverlässig?
Problem: Ladezeit und Antwortzeit werden oft in einen Topf geworfen. Core Web Vitals bewerten die Nutzererfahrung im Browser. Für den maschinellen Abruf zählen andere Größen: Server-Antwortzeit, Timeouts, Statuscodes und die Größe des ausgelieferten HTML.
Auswirkung auf die KI-Sichtbarkeit: Je nach System spielen Indexdaten, gecachte Inhalte und aktuelle Abrufe zusammen. Eine langsame oder unzuverlässige Serverantwort kann deshalb die Chance verringern, dass deine Quelle überhaupt verarbeitet wird. Belastbare, öffentlich dokumentierte Grenzwerte für Timeouts gibt es nicht, kursierende Sekundenangaben sind Beobachtungen einzelner Anbieter und keine Herstellerangaben.
Test: Server-Antwortzeit deiner wichtigsten URLs messen, die Statuscode-Verteilung in den Logs auswerten (Häufungen von 5xx, 429 und 403), die Größe der ausgelieferten HTML-Dokumente prüfen und das Verhalten unter Last testen.
Maßnahme: Erst Fehler und Ausreißer abstellen, dann die Antwortzeit stabilisieren, etwa über Caching und Serverkonfiguration. Die Core Web Vitals bleiben davon unberührt wichtig, nur eben für Nutzer:innen und für das klassische Ranking.
Problem: Hier stecken zwei Prüfebenen. Inhaltlich können KI-Systeme sowohl Dokument- als auch Passage-Signale verarbeiten, in der Praxis wird für eine Antwort aber oft nur ein Ausschnitt herangezogen. Technisch entscheidet die Indexierbarkeit darüber, ob es überhaupt eine eindeutige URL gibt, die zitiert werden kann.
Auswirkung auf die KI-Sichtbarkeit: Ein Absatz, der nur im Zusammenhang der ganzen Seite Sinn ergibt, ist als Zitat schwerer verwendbar. Widersprüchliche Indexierungssignale, etwa doppelte Inhalte oder unsaubere Canonicals, kosten dich im Zweifel genau die eine URL, die zitiert werden könnte.
Test: Nimm einen beliebigen Absatz aus einem wichtigen Text und lies ihn ohne den Rest der Seite. Ergibt er allein eine vollständige, korrekte Antwort? Prüfe parallel Überschriften-Hierarchie, XML-Sitemap, Canonicals, Statuscodes und Weiterleitungsketten.
Maßnahme: Inhalte in abgeschlossene Einheiten gliedern, mit einer H1, sauberen H2 und H3, Frage-Antwort-Paaren, Listen und Tabellen statt Text in Bildern. Das ist kein Argument gegen Tiefe, umfassend und gut geschnitten ist die Kombination, die trägt. Auf der technischen Seite: Sitemap aktuell halten und auch in den Bing Webmaster Tools einreichen, nicht nur in der Search Console.
Für die Darstellung in AI Overviews und im AI Mode sind laut Google keine neuen maschinenlesbaren Dateien, keine KI-Textdateien und kein spezielles Schema-Markup nötig, es gelten die üblichen SEO-Grundlagen. Das ordnet zwei Dauerbrenner ein. Die llms.txt bleibt damit ein Experiment ohne bestätigten Nutzen. Und strukturierte Daten sind sinnvoll, weil Google dokumentiert, dass sie beim Verständnis von Seiten und Entitäten helfen, sie sind aber keine Eintrittskarte. Für Anbieter außerhalb von Google gibt es zur Verarbeitung von Markup keine vergleichbar belastbare Dokumentation, entsprechende Aussagen sind Beobachtungen, keine Bestätigungen. Praktisch heißt das: Markup dort einsetzen, wo es deine Inhalte korrekt beschreibt, und widersprüchliche Angaben zuerst abstellen.
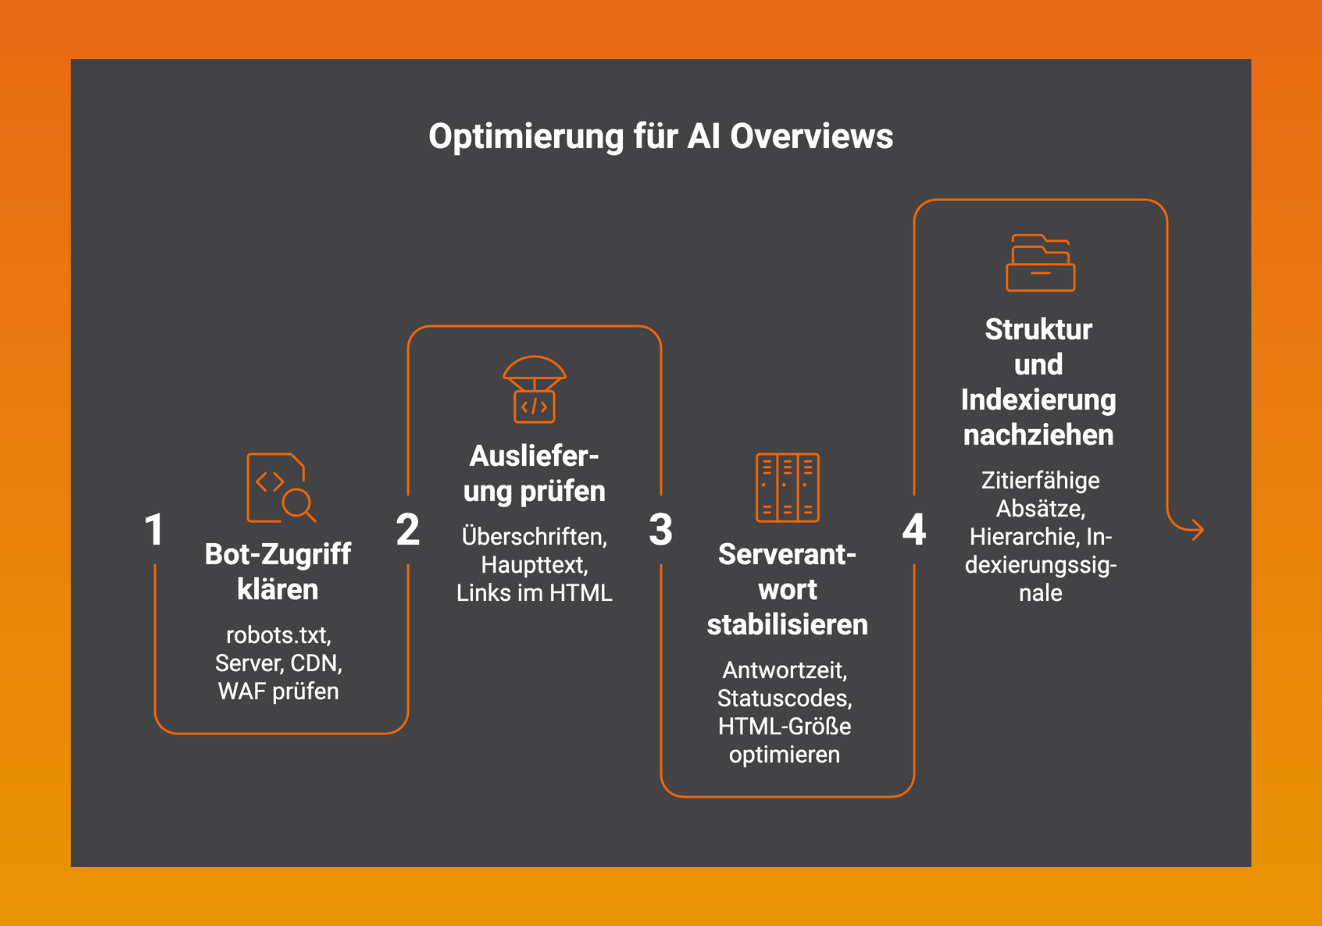
Erst danach lohnt die inhaltliche GEO-Arbeit an Entitäten, Autorität und Erwähnungen. Wer technisches SEO in den vergangenen Jahren ernst genommen hat, wird bei den meisten dieser Punkte einen Haken setzen können.
Wenn du diese Ebene systematisch angehen willst, findest du im Technical-GEO/SEO-Seminar mit Alin Radulescu genau diese Themen von der Crawler-Steuerung bis zu strukturierten Daten, und im GEO-Seminar mit Alexander Holl und Alin Radulescu den strategischen Rahmen dazu.
Hat dir der Artikel gefallen? Dann lass uns gerne eine Bewertung oder einen Kommentar da.
Dieser Artikel wurde KI-unterstützt erstellt und durch menschliche Fachkenntnis überarbeitet und optimiert.
Quellen:
cloudflare , cloudflare docs, Google Search Central , vercel , Open AI Help Center , Ahrefs , Search Engine Journal , Search Engine Journal , Search Engine Journal , Seokratie
Dein Feedback hilft uns, unsere Inhalte noch besser zu machen.
Schade! Bitte schreib uns kurz, was dir gefehlt hat – so werden wir besser.

 089 416126990
