 Autor:in
Eva Schmuhalek
Du kannst dir 121WATT-Inhalte in der Google-Suche jetzt bevorzugt anzeigen lassen.
 Warum ChatGPT-Traffic im Oktober scheinbar eingebrochen ist
Wenn du in GA4 auf den Oktober schaust, siehst du womöglich etwa zwischen dem 08. und 15. Oktober einen Rückgang beim Traffic aus ChatGPT und gleichzeitig mehr Direct-Traffic. Auch bei uns konnte man das in den Daten erkennen.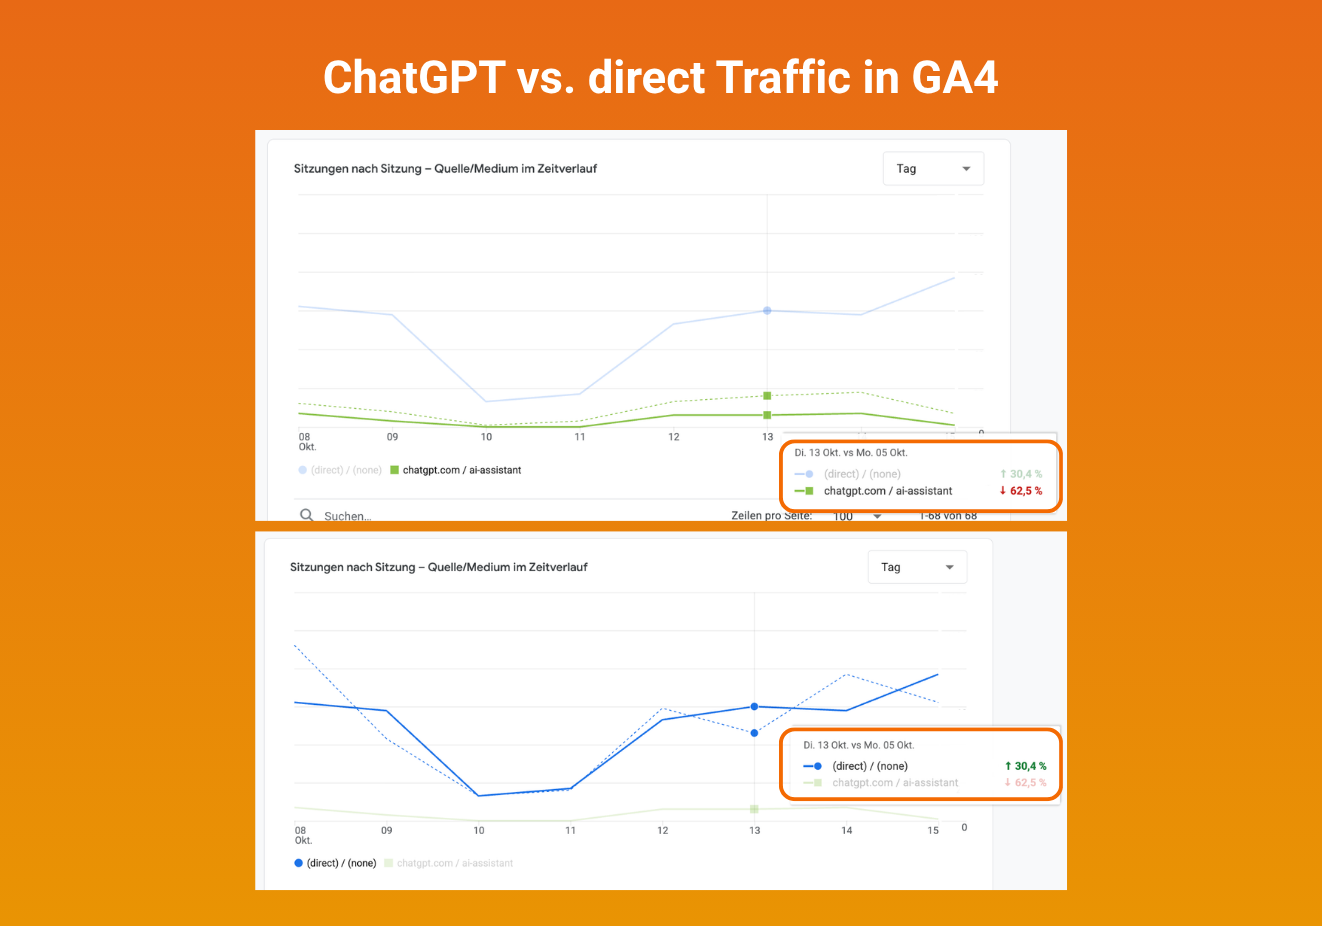
Die Ursache liegt nicht bei deinen Inhalten, sondern bei OpenAI: Nach dem Start von GPT-6 fehlte vielen Links in ChatGPT-Antworten der Parameter utm_source=chatgpt.com. Gleichzeitig wurde beim Klick kein Referrer übergeben.
OpenAI hat gegenüber Adobe am 14. Oktober bestätigt, dass es sich um einen bekannten Fehler handelt, und ab dem 15. Oktober einen Fix ausgerollt. Schon am Vormittag des 15. Oktober (US-Westküstenzeit) lagen die getaggten ChatGPT-Klicks laut Adobe-Daten über tausender Domains wieder bei 95 bis 100 Prozent des Vorwochenniveaus.
Analytics-Tools wie GA4 ordnen einen Besuch über zwei Signale einer Quelle zu: den UTM-Parameter in der URL und den Referrer, also die Information, von welcher Seite jemand kommt. Fehlt beides, landet der Besuch unter Direct. Genau das ist in der Oktober-Woche passiert. Die Besuche aus ChatGPT gab es weiterhin, sie wurden nur falsch zugeordnet.
Auch nach dem Fix fehlt bei den meisten ChatGPT-Klicks der Referrer. Das UTM-Tag ist damit das wichtigste Signal, über das du ChatGPT-Traffic überhaupt erkennst.
Wenn du Sichtbarkeit in KI-Antworten oder Leads aus ChatGPT reportest, verzerrt diese Woche deine Oktober-Zahlen, im Monatsvergleich jetzt und im Jahresvergleich 2027. Ohne Erklärung liest sich der Knick wie ein Performance-Problem. Der Fall zeigt außerdem, wie stark die Messung von KI-Traffic an einem einzigen URL-Parameter hängt, den der Plattformbetreiber jederzeit ändern kann, ohne es anzukündigen.
Lege in GA4 eine Anmerkung für den Zeitraum 8. bis 15. Oktober 2026 an, damit niemand in deinem Team den Rückgang als echten Einbruch interpretiert. Prüfe außerdem, ob sich die ChatGPT-Sitzungen auf deiner Website erholt haben: Vergleiche die Werte ab dem 16. Oktober mit denselben Wochentagen Ende September. Ein neues Attributionsmodell brauchst du wegen dieses Fehlers nicht.
Quellen: Search Engine Land, eology
 Meta lässt sich das Crawlen verknüpfter Websites erlauben
Meta ändert seine Commercial Terms, also die Geschäftsbedingungen für alle, die Facebook, Instagram, Messenger oder WhatsApp geschäftlich nutzen. Betroffen ist nicht nur, wer Anzeigen schaltet: Schon eine Unternehmensseite oder ein Business-Profil reicht. Neu ist eine Klausel, nach der Meta die mit einem Unternehmen verknüpften Domains und Seiten automatisiert durchsuchen, indexieren, zwischenspeichern und auswerten darf, um seine Werbe- und Geschäftsprodukte zu entwickeln und zu verbessern. Ursprünglich sollte das ab dem 30. Oktober gelten. Nach Beschwerden von Verlagen und Werbetreibenden bei den Wettbewerbsbehörden in der EU und Großbritannien hat Meta den Start auf den 20. November 2026 verschoben. Die Klausel selbst hat Meta aber (noch) nicht zurückgenommen.
Die Zustimmung läuft über die Weiternutzung: Nutzt du Metas Produkte nach dem 20. November weiter geschäftlich, akzeptierst du damit die neuen Bedingungen. Ein Opt-out gibt es nicht. Wer nicht einverstanden ist, müsste die geschäftliche Nutzung einstellen. In einer früheren Fassung stand ausdrücklich, dass Meta die Inhalte zum „Trainieren“ seiner Produkte nutzen darf. Dieses Wort hat Meta nach Kritik gestrichen. Rechtsexpert:innen halten das für wenig aussagekräftig, weil „entwickeln“ weit genug gefasst sei, um KI-Training weiterhin abzudecken.
In Deutschland fordern die Verlegerverbände BDZV und MVFP die EU-Kommission auf, die Klausel zu prüfen und ihre Anwendung bis dahin zu untersagen. Sie stützen sich auf den Digital Markets Act, der Meta als Gatekeeper zu fairen Zugangsbedingungen für gewerbliche Nutzer:innen verpflichtet. Auch der European Publishers Council verlangt eine dringende Prüfung. Die EU-Kommission hat die Verschiebung begrüßt, ein förmliches Verfahren ist bislang nicht bekannt. Ob die Klausel am 20. November unverändert gilt, ist damit offen.
Die Debatte wird von Verlagen geführt, die Klausel betrifft aber jedes Unternehmen mit Meta-Präsenz. Sobald du auf der eigenen Website Fachartikel, Whitepaper oder Produktwissen veröffentlichst, stellst du Meta damit potenziell Material für dessen KI-Produkte zur Verfügung.
Vertraglich nur, indem du Meta nicht mehr geschäftlich nutzt. Für die meisten Marketing-Teams ist das keine realistische Option. Technisch gibt es einen Weg, auf den Meta selbst verweist: Laut einem Meta-Sprecher können Website-Betreiber:innen ihre Präferenzen weiterhin über die robots.txt festlegen, und die neuen Bedingungen sollen diese nicht übersteuern. Meta setzt mehrere Crawler mit unterschiedlichen Aufgaben ein, die du einzeln steuern kannst:
Eine Sperre für den Trainings-Crawler sieht in der robots.txt so aus:
User-agent: meta-externalagent
Disallow: /
Die Grenzen solltest du kennen. Die robots.txt ist eine Anweisung an Crawler, keine rechtliche Sperre, und Metas Zusage steht in einer Sprecheraussage, nicht im Vertragstext. Laut Metas eigener Dokumentation kann facebookexternalhit die robots.txt bei Sicherheitsprüfungen ignorieren, ebenso meta-externalfetcher bei Abrufen, die Nutzer:innen direkt auslösen. Änderungen an der robots.txt können bis zu 24 Stunden brauchen, bis Meta sie berücksichtigt. Und was bereits gecrawlt wurde, holst du mit einer späteren Sperre nicht zurück.
Nutze die Zeit bis zum 20. November. Kläre, welche Domains mit euren Meta-Konten verknüpft sind und wer im Team die Business-Konten verwaltet. Lege dann in der robots.txt fest, welcher Meta-Crawler was darf. Für die meisten Unternehmen ist ein guter Ausgangspunkt, meta-externalagent zu sperren und facebookexternalhit zuzulassen. Ob du auch meta-webindexer sperrst, hängt davon ab, wie wichtig dir Sichtbarkeit in Meta AI ist. Prüfe außerdem, welche Inhalte auf deiner Website öffentlich erreichbar sind, die es nicht sein sollten. Bis zum Stichtag lohnt es sich zu beobachten, ob Meta oder die EU-Kommission noch nachbessern.
Quellen: digital-magazin.de, PPC Land, Meta for Developers, Meta Commcercial Terms
Hat dir der Artikel gefallen? Dann lass uns gerne eine Bewertung oder einen Kommentar da.
Dieser Artikel wurde KI-unterstützt erstellt und durch menschliche Fachkenntnis überarbeitet und optimiert.
Deine Stimme entscheidet mit, welche Themen wir als Nächstes vertiefen.
Optional, aber Gold wert für unsere Redaktion.
Danke, du hast dieser Artikel bereits bewertet.

 089 416126990