Wie oft empfiehlt ein KI-Assistent ein konkretes Produkt, wenn jemand kaufen will? Ein Praxisbericht von Alexander Holl und Dr. Christoph Röck über unseren Messansatz in der 121suite – und seine Grenzen.
Du kannst dir 121WATT-Inhalte in der Google-Suche jetzt bevorzugt anzeigen lassen.
Bringt Sichtbarkeit in KI-Assistenten überhaupt Geschäft? Diese Frage spaltet gerade die Branche. Klickstudien sagen: kaum. Wir halten Klicks für den falschen Maßstab, wollen uns aber auch nicht auf Behauptungen verlassen.
Mit der 121suite messen wir deshalb, wie oft ein KI-Assistent ein konkretes Produkt empfiehlt, wenn sich jemand nach einer Lösung erkundigt. Wir simulieren dazu mehrstufige Kaufgespräche, statt lediglich Markennennungen in einzelnen Antworten zu zählen. Das liefert vergleichbare Hinweise darauf, wer in der Vorauswahl vorkommt, wer zum Favoriten wird und welche Kriterien den Ausschlag geben.
Es bleibt aber eine Messung synthetischer Gespräche – kein Abbild realer Käufer. Und eine höhere Empfehlungsquote ist noch kein Umsatznachweis. Den Geschäftseffekt prüfen wir deshalb getrennt, über die Selbstauskunft der Kunden. Im Folgenden zeigen wir, wie wir vorgehen, was wir bewusst verworfen haben und wo die Grenzen liegen.
Sichtbarkeitsmessung in KI-Systemen ist – genauso wie das Thema GEO insgesamt – umstritten. Rand Fishkin hat im Oktober 2026 drei Studien zusammengefasst, die die Geschäftswirkung von KI-Sichtbarkeit außerhalb der Google-Suche skeptisch beurteilen:
Marie Haynes: GEO is a Distraction – KI-Assistenten schicken nur einen Bruchteil des Website-Traffics.
The SEO Works: AI Referral Traffic Benchmark – KI-Referral-Traffic ist klein, wächst aber gemeinsam mit dem organischen Traffic.
Kevin Indig: Does AI drive more direct traffic? – ein vermuteter großer „versteckter“ KI-Anteil im Direct-Kanal ließ sich im untersuchten Datensatz nicht nachweisen.
Fishkin selbst unterscheidet ausdrücklich: Googles eigene KI (AI Overviews, AI Mode, Gemini) zählt. Die Gegenposition vertreten u. a. Michael King („KI-Suche ist ein Branding-Kanal“) und Christian Kunz: Einen Kanal, der Klicks überflüssig machen soll, sollte man nicht nach Klicks bewerten.
Fishkins Whiteboard im Detail. In seinem #5minutewhiteboard fragt Fishkin zugespitzt, ob KI-Sichtbarkeit ein Hirngespinst, eine Täuschung oder eine Ablenkung ist. Nach der Lektüre der drei Studien sei er weniger denn je überzeugt, dass mehr Sichtbarkeit in ChatGPT, Claude, Perplexity oder Copilot für die meisten Unternehmen viel Geschäft bringt. In der Diskussion legt er nach: In Clickstream-Daten, die er gerade auswerte, korreliere KI-Sichtbarkeit bis auf seltene Ausnahmen nicht so mit Umsätzen wie andere Kanäle.
Drei Fragen stellt er dem Markt:
Wie viele der rund eine Milliarde Nutzer stellen überhaupt suchartige Fragen, bei denen sie Marken entdecken?
Wie viele dieser Fragen fallen in die eigene Branche – und wie stark beeinflussen die Antworten die eigenen Kunden?
Wenn beides unbekannt ist: Warum fließt so viel Geld in das Tracking von KI-Sichtbarkeit?
Diese Fragen sind berechtigt. Für ein einzelnes Unternehmen ist aber vielleicht gar nicht entscheidend, wie viele Fragen genau zum eigenen Produkt gestellt werden – sondern ob das eigene Produkt empfohlen wird, wenn gefragt wird. Wie wichtig KI-Assistenten inzwischen sind, sieht jeder am eigenen Nutzungsverhalten und an öffentlich verfügbaren Nutzerzahlen. Wir haben deshalb einen Ansatz entwickelt, mit dem sich eine Aussage darüber treffen lässt, wie verlässlich eine Sichtbarkeitsmessung bei KI-Produktempfehlungen ist. Die Messung verstehen wir dabei nicht als Beleg für Geschäft, sondern als Diagnose: Wer wird statt uns empfohlen, nach welchem Kriterium und auf Basis welcher Quellen?
Den Geschäftseffekt prüfen wir getrennt: Wir fragen nicht allgemein nach der „wichtigsten Informationsquelle“, sondern direkt nach dem Abschluss nach dem Auslöser eines konkreten Kaufs, mit Zufallsreihenfolge und Scheinoption. Verzerrungen bleiben trotzdem. Deshalb lesen wir dort Entwicklungen über die Zeit, keine absoluten Anteile.
Wir glauben, beide Blickwinkel erfassen etwas Wichtiges. Klickstudien messen nachweisbaren Besucherstrom. Unsere Messung prüft, ob ein Angebot in einem simulierten Auswahlprozess empfohlen wird. Keines von beidem beantwortet allein die Frage nach dem tatsächlichen Umsatzbeitrag.
| Kritischer Einwand | Unsere Antwort | Was offen bleibt |
|---|---|---|
| „KI bringt kaum Traffic.“ | Wir messen die Empfehlung vor einem möglichen Klick. | Ob daraus zusätzlicher Umsatz entsteht – dafür fragen wir die Kunden. |
| „Synthetische Prompts sind keine Käufer.“ | Mehrstufige Dialoge, geprüfte Prompts, Wiederholungen, Websuche im Zielmarkt. | Echte Fragen, Personalisierung und Nutzerkontext. |
| „Google ist relevanter.“ | Gemini ist einer der vier gemessenen Assistenten. | AI Overviews und AI Mode messen wir nicht direkt. |
| „GEO-Tricks funktionieren nur kurzfristig.“ | Wir zeigen Kriterien und Quellen, also Ansatzpunkte für Marken- und PR-Arbeit. | Wirkung und zeitliche Stabilität einzelner Maßnahmen. |
| „Eine globale Zahl verdeckt verlorene Märkte.“ | Gemessen wird je Markt, in seiner Sprache und mit seiner Websuche. | – |
In der klassischen Google-Suche kennen wir Rankings: Für ein Keyword steht eine Seite auf einer bestimmten Position. Die kann sich verändern, ist aber grundsätzlich beobachtbar. Bei ChatGPT und anderen KI-Assistenten funktioniert das anders. Jede Antwort hängt vom Prompt, dem bisherigen Gespräch, dem verwendeten Modell und gegebenenfalls der Websuche ab.
Viele GEO-Tools stellen deshalb eine Reihe von Fragen und zählen, wie häufig eine Marke auftaucht. Das ist nicht uninteressant. Es beantwortet vor allem die Frage: „Kennt die KI unsere Marke?“ Für Marketing und Vertrieb interessiert uns aber etwas anderes:
Wird unser konkretes Produkt empfohlen, wenn ein potenzieller Kunde eine Entscheidung vorbereitet – und wenn nicht, welcher Wettbewerber stattdessen?
Daraus leiten wir drei Analysefragen ab: Wie sichtbar ist unser Angebot während der Auswahl? Aufgrund welcher Eigenschaften wird es empfohlen oder übergangen? Und welche Quellen nutzt der Assistent für seine Antwort?
Ein Beispiel aus der Weiterbildung: Ein Anbieter kann für ein SEO-Seminar regelmäßig empfohlen werden, bei einer KI-Schulung für Teams aber kaum auftauchen. Ein einziger Markenwert würde diesen Unterschied verschlucken. Deshalb messen wir jedes Produkt beziehungsweise jede Leistung einzeln.
Die Ausgangsbasis ist die jeweilige Produktdetailseite. Aus ihr übernehmen wir Name, Zielgruppe, Nutzen sowie typische Probleme und erwartete Vorteile (Pains & Gains). Die Seite wird einmal eingelesen; der gespeicherte Stand bleibt für den Prompt-Entwurf erhalten, bis jemand sie gezielt aktualisiert. KI-Vorschläge werden erst nach menschlicher Bestätigung übernommen.
Statt den Assistenten einmal nach den „besten Anbietern“ zu fragen, führen wir mit ihm ein mehrstufiges Gespräch. Wir starten offen, lassen eine Top 3 bilden und fragen anschließend nach einem Favoriten. Danach ändern wir gezielt ein Kriterium, etwa Preis oder Praxisnähe. Jede Antwort bleibt im Gesprächskontext – so wie bei einem echten Dialog. Eine Messeinheit ist ein Gespräch: Prompt × Assistent × Wiederholung.
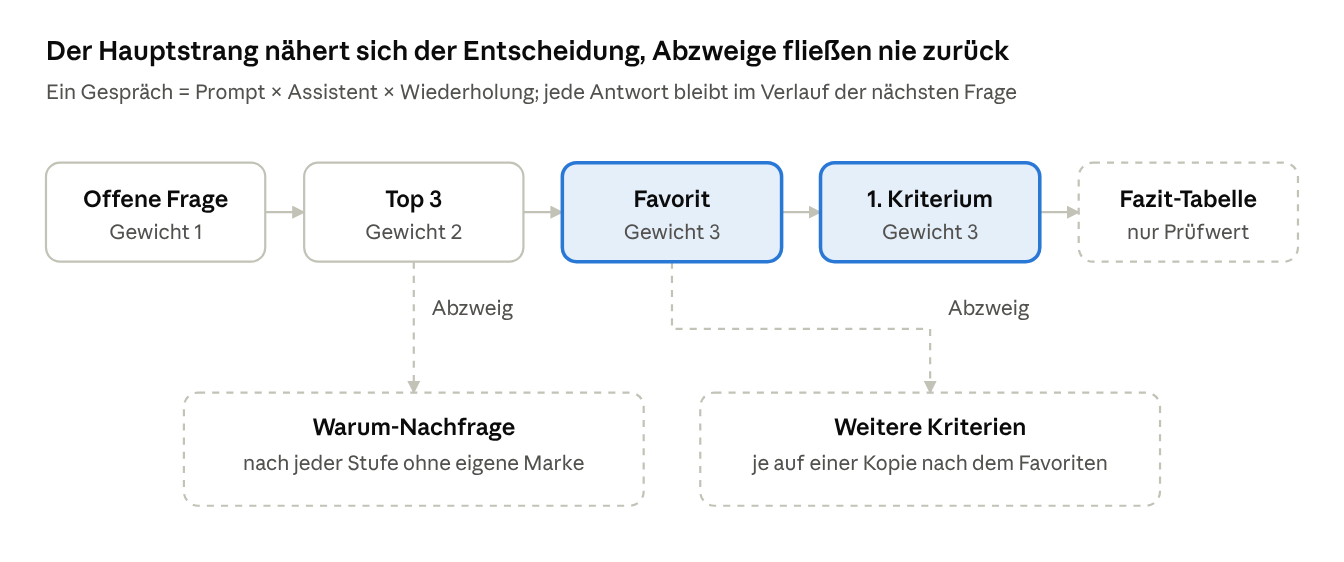
Abb. 1: Vier aufeinander aufbauende Stufen; Nachfragen laufen in separaten Gesprächsabzweigen
| Stufe | Beispielfrage | Gewicht |
|---|---|---|
| Offene Frage | „SEO-Schulung speziell für Onlineshops?“ | 1 |
| Top 3 | „Welche drei Anbieter würdest du empfehlen?“ | 2 |
| Favorit | „Für welchen würdest du dich entscheiden?“ | 3 |
| Favorit nach Kriterium | „Und wenn mir besonders der Preis wichtig ist?“ | 3 |
Zwei Arten von Nachfragen trennen wir bewusst vom Hauptgespräch. Erstens fragen wir zusätzliche Kriterien jeweils ausgehend vom selben Gesprächsstand ab. Sonst könnte die Preisfrage die spätere Qualitätsantwort verfälschen. Zweitens fragen wir bei fehlender Markennennung nach dem Warum – aber ebenfalls nur in einem Abzweig. Würden wir unsere Marke direkt in das Hauptgespräch einführen, würden wir mit der Nachfrage die nächste Empfehlung beeinflussen und am Ende unsere eigene Frage messen.
Am Ende lassen wir den Assistenten sein Gespräch tabellarisch zusammenfassen. Diese Selbstauskunft des Modells ist für uns eine Kontrollgröße. Gezählt werden die von uns ausgewerteten Antworten, nicht das, was das Modell im Nachhinein über sich selbst behauptet.
Die Qualität der gesamten Messung steht und fällt mit den Fragen. Wenn wir schlechte oder sehr ähnliche Prompts auswählen, misst auch ein noch so präziser Index nur die Schwächen unseres Fragebogens. Deshalb lassen wir die Prompts nicht einfach frei generieren.
Wir nutzen etablierte Marketing-Frameworks: Funnel (TOFU, MOFU, BOFU), AIDA, See-Think-Do-Care, Messy Middle sowie Kaufmotive oder Pains & Gains. Eigene Frameworks sind ebenfalls möglich. Nicht passende Stufen werden bewusst ausgeschlossen.
Jeder Prompt muss generisch formuliert sein und auf eine Anbieterempfehlung abzielen. Er darf weder unsere Marke noch einen Wettbewerber nennen. Eine Frage wie „Welche Alternativen gibt es zu Anbieter X?“ wäre eine andere Messart und gehört nicht in dieses Panel.
Bei den Prompts verfolgen wir zwei Ziele, die sich nur scheinbar widersprechen: Innerhalb einer Stufe sollen die Fragen möglichst verschieden sein – und trotzdem alle möglichst gut zu genau dieser Stufe passen. Wir wollen verschiedene Wege zur gleichen Kaufabsicht abbilden, nicht sechsmal dieselbe Frage stellen.
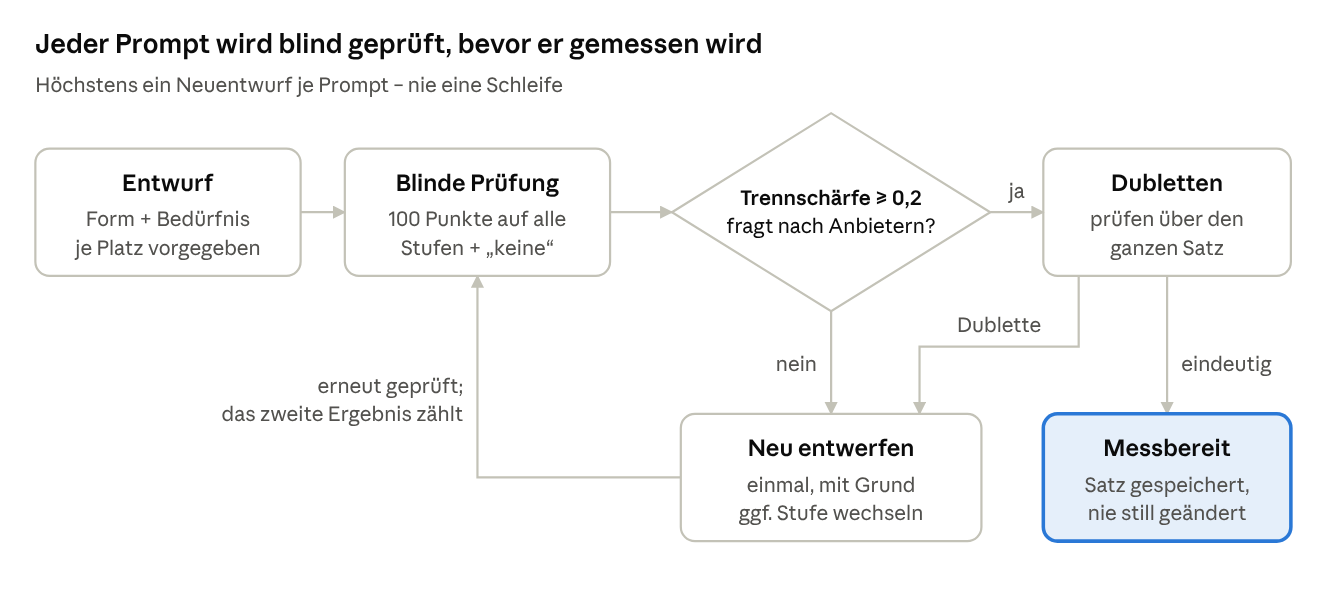
Abb. 2: Entwurf, blinde Prüfung, höchstens ein Neuentwurf und Dublettenprüfung vor der Messung
Das Grundproblem jeder GEO-Messung: Zu einem Thema wie „SEO-Seminar“ gibt es nicht zehn Fragen, sondern Millionen unterschiedlicher Gespräche. Menschen wählen andere Worte, bringen anderes Vorwissen mit, beschreiben andere Situationen und fragen anders nach. Keine Messung kann all diese Gespräche führen, und niemand kennt ihre tatsächliche Verteilung.
Wir gehen deshalb vor wie in der empirischen Forschung: Wir bilden eine Stichprobe. Sie besteht aus Prompts zum selben Thema, die möglichst unabhängig voneinander sind – verschiedene Motive, Frageformen und Bedürfnisse, keine zwei Varianten derselben Frage. Unabhängig heißt hier: Die Prompts teilen das Thema, aber nicht die Formulierung. Wie wir das sicherstellen, beschreiben die beiden folgenden Abschnitte.
Daraus folgt die zentrale Schlussregel:
Wird bei diesen bewusst verschiedenen Prompts immer wieder dasselbe Produkt oder dieselbe Leistung empfohlen, können wir davon ausgehen, dass diese Empfehlung auch bei vielen, wahrscheinlich den meisten anderen Varianten kommt. Die Empfehlung hängt dann am Thema, nicht an der Formulierung.
Werden dagegen bei jedem Prompt andere Anbieter genannt, ist das Ergebnis nicht stabil. Eine einzelne Quote ist dann wenig aussagekräftig – oder die KI hat sich zu diesem Thema schlicht noch keine „Meinung“ gebildet. Auch das ist ein Befund: Der Markt ist in der KI noch offen, und kleine Änderungen der Frage entscheiden über die Empfehlung.
Das Prinzip kennt man aus jeder Befragung: Sagen zehn sehr unterschiedliche Menschen unabhängig voneinander dasselbe, spricht viel dafür, dass es auch die anderen so sehen. Sagt jeder etwas anderes, gibt es keine gefestigte Mehrheitsmeinung.
Um Formulierung und Zufall auseinanderzuhalten, kombinieren wir zwei Vergleiche: die Übereinstimmung zwischen Wiederholungen desselben Prompts und die Übereinstimmung zwischen verschiedenen Prompts zum selben Produkt (Rechnung im Abschnitt zur Stabilität weiter unten).
| Wiederholungen eines Prompts | Verschiedene Prompts | Lesart |
|---|---|---|
| stimmen überein | stimmen überein | Robuste Empfehlung: gilt vermutlich auch für viele ungemessene Varianten. |
| stimmen überein | weichen ab | Die Formulierung entscheidet: Jede Frage hat ihre eigene stabile Antwort. Das Ergebnis gilt nur für Fragen dieser Art. |
| weichen ab | weichen ab | Keine gefestigte „Meinung“: Der Zufall dominiert. Mehr Wiederholungen helfen, oder der Markt ist in der KI noch offen. |
Wichtig ist die Einordnung: Unsere Prompt-Sets ähneln einer Quotenstichprobe. Wir schichten nach Kaufphasen oder Motiven und besetzen jede Schicht mit möglichst verschiedenen Fragen. Innerhalb der Schichten ziehen wir aber nicht zufällig aus echten Gesprächen, und wie groß jede Schicht in der Realität ist, weiß niemand. Der Schluss auf ungemessene Prompts ist deshalb ein Plausibilitätsschluss, kein statistischer Beweis. Wie weit der Schluss trägt, hängt davon ab, wie verschieden die Prompts wirklich sind – genau deshalb prüfen wir Vielfalt und Dubletten so streng. Eine feste Schwelle, ab der ein Set als aussagekräftig gilt, legen wir bewusst noch nicht fest; wir lesen die Übereinstimmung als Kontinuum.
Beim Entwurf bekommt jeder Platz einer Stufe eine Frageform und ein zum Motiv passendes Bedürfnis vorgegeben. Anschließend ordnet ein zweites Modell die Prompts blind allen Stufen des Frameworks zu – einschließlich der Kategorie „keine“. Die beabsichtigte Stufe wird nicht verraten. Je Prompt verteilt es Punkte danach, wie stark die einzelnen Kaufmotive zum Ausdruck kommen.
Daraus berechnen wir zwei Kennzahlen:
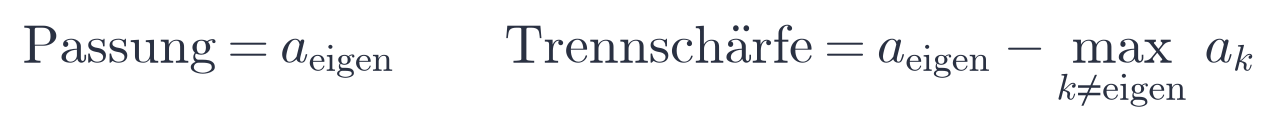
Dabei ist a der Punkteanteil einer Stufe. Die Passung sagt, wie klar ein Prompt sein Motiv ausdrückt. Die Trennschärfe sagt, wie deutlich er sich vom stärksten Nachbarmotiv abhebt. Ist sie zu gering, misst der Prompt ebenso gut das Nachbarmotiv.
Unterschreitet ein Prompt unseren Mindestwert oder zielt er nicht auf eine konkrete Anbieterempfehlung, entwerfen wir ihn mit gezieltem Feedback einmal neu. Auch dieses zweite Prüfergebnis bleibt dokumentiert – wir optimieren also nicht endlos auf einen Prüfwert. Passt ein Prompt besser in eine andere Stufe, wird er dorthin umsortiert.
Was wir beobachtet haben: Bei 192 Motiv-Prompts für 121WATT-Seminare erhielt die vorgesehene Stufe in 96 % der Fälle die höchste Punktzahl. Im Durchschnitt entfielen aber nur rund zwei Drittel der Punkte auf die eigene Stufe. Die Fragen sind also überwiegend gut zuzuordnen, enthalten aber häufig Aspekte benachbarter Motive.
Inhaltliche Dubletten. Ein Prüfmodell gruppiert über den ganzen Fragensatz die Prompts, die inhaltlich dasselbe verlangen – auch wenn sie sprachlich verschieden aussehen. Von einer Gruppe behalten wir den Prompt mit der höheren Stufenpassung, die übrigen werden neu entworfen.
Formale Vielfalt. Jede Frage erhält eine Form-Signatur aus Satzform, Kontext und Vergleichsmodus. Je Stufe zählen wir die eigenständigen Fragen und die verschiedenen Form-Signaturen. Ideal ist in beiden Fällen die Zahl der eingesetzten Prompts.
Warum wir Formen und Bedürfnisse schon beim Entwurf vorgeben: Ohne Formvorgabe folgten 73 % der Motiv-Prompts praktisch demselben Muster („Ich suche …, könnt ihr etwas empfehlen?“). Die Bedürfnisse müssen dabei zum Motiv der Stufe passen. Ein Bedürfnis aus einem fremden Motiv zieht den Prompt sonst zu diesem Motiv hin.
Auch Embedding-Ähnlichkeit haben wir getestet. Sie erwies sich als ungeeignet: Sie erkennt vor allem das gemeinsame Produktvokabular, nicht das Kaufmotiv. Deshalb prüfen wir Passung und Dubletten über die inhaltliche Einordnung durch ein Modell.
Zwischenfazit: Gute Prompts sind ihrer Stufe inhaltlich nah, untereinander aber möglichst wenig redundant. Diese Prüfungen verbessern unser konstruiertes Panel; eine repräsentative Abbildung realer Nutzerfragen garantieren sie nicht. Und sobald ein Prompt-Satz gemessen wurde, verändern wir ihn nicht stillschweigend: Neue Prompts sind eine neue Stichprobe, und dieser Bruch ist im Zeitverlauf markiert.
Für jedes Produkt und jeden Prompt führt die 121suite separate Gespräche mit ChatGPT, Gemini, Claude und Perplexity über deren APIs – jeweils mit Websuche.
Sprache und Markt sind entscheidend. Wer den spanischen Markt untersucht, muss auf Spanisch fragen und in der spanischen Websuche messen – unabhängig davon, ob die Benutzeroberfläche deutsch ist. Ohne Standortangabe suchen manche Anbieter aus den USA; mit Standortangabe steigt der Anteil lokaler Quellen deutlich. Nicht jede Schnittstelle bietet diese Steuerung, die Assistenten sind also nicht vollständig vergleichbar.
Wiederholung statt Scheingenauigkeit. Die Antworten generativer Modelle schwanken. Deshalb wiederholen wir jedes Gespräch mehrfach. So wird sichtbar, ob ein Anbieter regelmäßig genannt wird oder nur zufällig auftaucht. Gemessen wird manuell oder im monatlichen Turnus. Abgebrochene Einzelgespräche holen wir mit demselben Modell nach, damit nicht zwei Messzeitpunkte vermischt werden.
Das Modell ist Teil der Messbedingung. Als Standard verwenden wir das leistungsstärkste Modell des jeweiligen Anbieters, dessen Websuche wir geprüft haben. Wird es ersetzt, dokumentieren wir den Modellwechsel im Zeitverlauf. Denn ein anderes Modell ist letztlich auch ein anderes Messinstrument.
Eine bloße Erwähnung ist nicht das Gleiche wie eine Empfehlung. Deshalb analysiert ein separates Auswertungsmodell jede Antwort, extrahiert alle genannten Anbieter und weist jeder Nennung eine Rolle zu. Die eigene Marke gleichen wir zusätzlich mit dem Rohtext ab, damit eine übersehene Extraktion nicht einfach untergeht.
| Rolle | Bedeutung |
|---|---|
| Empfehlung | Der Assistent rät ausdrücklich zu einem Anbieter. |
| Neutral | Der Anbieter wird erwähnt, aber nicht bewertet. |
| Kritisch | Der Anbieter wird mit Warnung oder Einschränkung genannt. |
| Nur als Quelle | Die eigene Website wird zitiert, die eigene Marke kommt in der Antwort aber gar nicht vor: Der Inhalt wird gelesen, das Angebot nicht empfohlen. |
Kommen in einer Antwort mehrere Rollen für denselben Anbieter vor, hat die kritische Nennung Vorrang vor Empfehlung und neutraler Erwähnung. Eine Warnung soll nicht im positiven Durchschnitt verschwinden.
Hinzu kommt ein praktisches Problem: Ein Assistent schreibt „Haufe“, ein anderer „Haufe Akademie“. Die Anwendung schlägt mögliche Zusammenführungen vor, entscheiden muss aber ein Mensch. Die Rohantwort bleibt unverändert; Zuordnungen lassen sich jederzeit wieder lösen.
Wir berechnen zunächst je Gesprächsstufe die Quote der Antworten, in denen ein Anbieter vorkommt. Daraus bilden wir einen gewichteten Mittelwert zwischen 0 und 100. Die offene Frage hat Gewicht 1, die Top 3 Gewicht 2, die beiden Favoriten-Stufen jeweils Gewicht 3. Späte Stufen wiegen mehr, weil sie einer konkreten Entscheidung näherkommen.
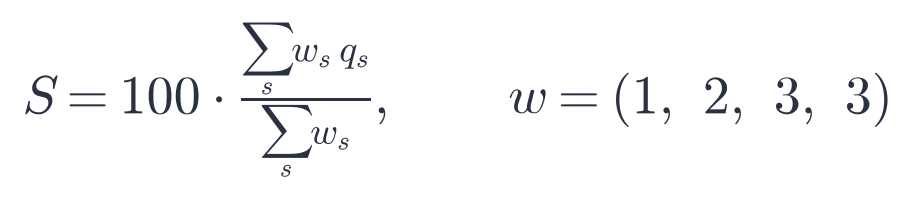
Stufen ohne Antwort fallen aus dem Nenner heraus und werden nicht irrtümlich als null gewertet. Über mehrere Produkte hinweg zählt jedes Produkt gleich: Wir aggregieren erst pro Produkt und bilden dann den Mittelwert. Sonst würden Produkte mit vielen Prompts die Gesamtsicht verzerren. Ein Produkt ohne Messung erscheint als „nicht gemessen“, nie als 0 %.
Hier ist uns eine begriffliche Präzisierung wichtig: Der Index ist ein gewichteter Empfehlungs- und Nennungsindikator. Er ist keine Wahrscheinlichkeit dafür, dass ein realer Käufer eine bestimmte Empfehlung erhält. Sein sinnvoller Einsatz liegt in strukturierten Vergleichen – mit Wettbewerbern, zwischen Assistenten und über die Zeit. Wann ein Vorsprung belastbar ist, beschreiben wir im Abschnitt zur Zuverlässigkeit der Messung.
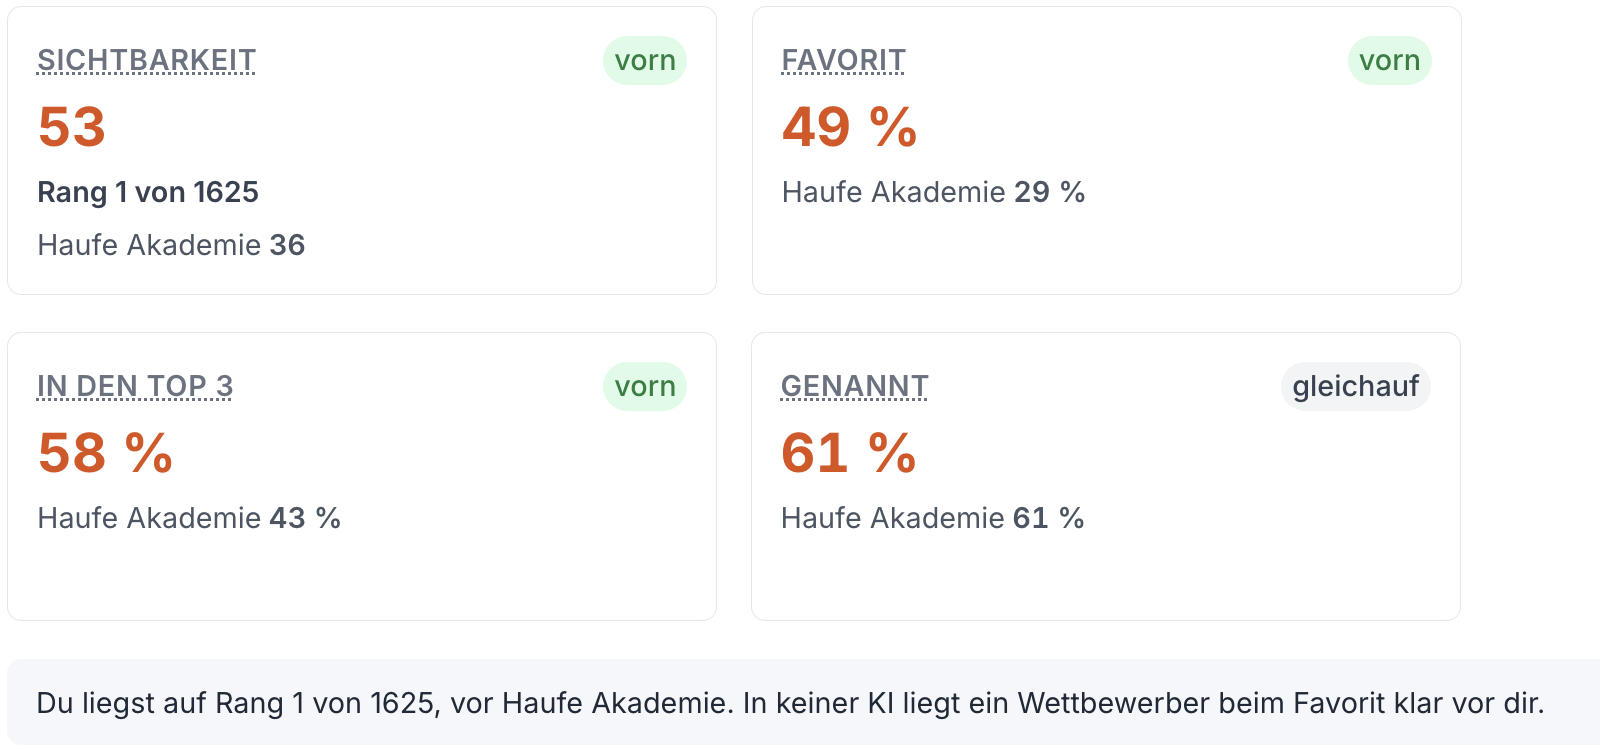
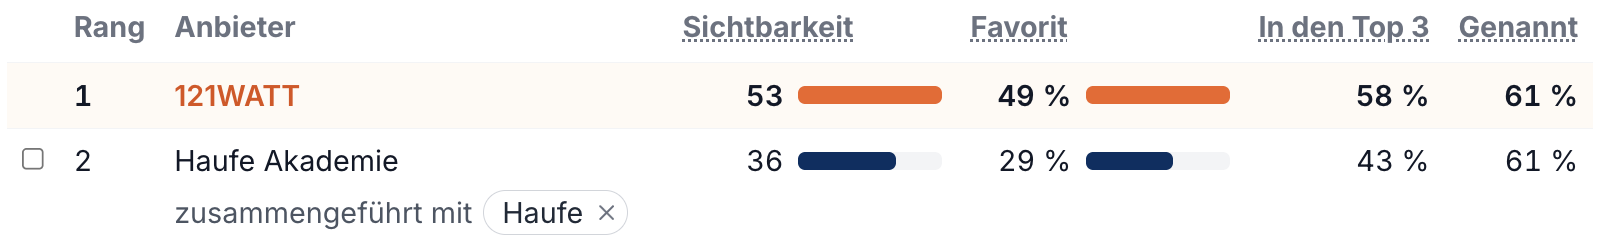
Abb. 3: Ausschnitt eines 121suite-Testlaufs – Sichtbarkeit. Lagebild mit Sichtbarkeit, Favorit, Top 3 und Nennung im Vergleich zum stärksten Wettbewerber, darunter die Rangliste der Anbieter (Grundlage: 787 Gespräche).
Wir betrachten zwei Fragen getrennt. Reliabilität: Bekommen wir unter ähnlichen Bedingungen ähnliche Antworten? Validität: Messen wir überhaupt das Verhalten, das uns interessiert?
Jede Quote ist ein Anteil p aus n Antworten. Als einfache Näherung verwenden wir den binomialen Standardfehler:
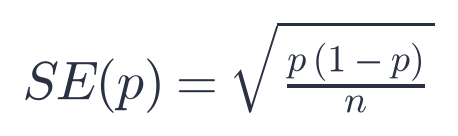
Für den Sichtbarkeitsindex kombinieren wir die Standardfehler der Stufen entsprechend ihren Gewichten und behandeln die Stufen dabei als unabhängig. Beim Vergleich mit einem Wettbewerber prüfen wir die Differenz d zweiseitig auf dem 95-%-Niveau:
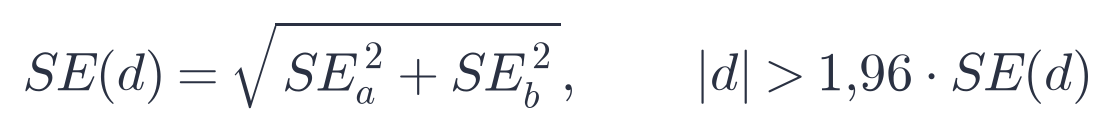
Nur dann zeigt die Auswertung „vorn“ oder „dahinter“, sonst „gleichauf“. Ein Beispiel: Bei 300 Antworten und einer Favoriten-Quote von 43 % gegen 45 % liegt die Schwelle bei rund 7,9 Prozentpunkten – zwei Punkte Unterschied sind „gleichauf“. Wichtig: „Gleichauf“ heißt bei uns ausdrücklich „kein statistisch nachweisbarer Unterschied“, nicht, dass zwei Anbieter wirklich gleich stark sind. Dieselbe Regel gilt für jede KI einzeln, je Produkt und je Kriterium.
Das klingt nach einer klaren Grenze, verlangt aber eine wichtige Einschränkung: Die Rechnung behandelt Antworten als unabhängig. Tatsächlich wiederholen wir dieselben Prompts, und die Stufen eines Kaufgesprächs bauen aufeinander auf. 30 ähnliche Antworten sind nicht automatisch 30 unabhängige Beobachtungen. Der berechnete Standardfehler kann deshalb zu klein und ein ausgewiesener Vorsprung zu sicher erscheinen. Die 95-%-Schwelle ist vorerst eine Orientierung unter vereinfachenden Annahmen, kein Beweis.
Ein sinnvoller nächster Schritt ist ein Bootstrap auf Prompt-Ebene: Dabei werden ganze Prompts samt aller Wiederholungen und Gesprächsstufen neu gezogen, statt einzelne Antworten als unabhängig zu behandeln. So lässt sich für Index und Differenzen eine robustere Unsicherheit schätzen. Die Frage, wie repräsentativ synthetische Fragen für echte Kaufgespräche sind, löst aber auch das nicht.
Wenn ein Assistent auf zehn fast identische Fragen zehnmal denselben Anbieter nennt, ist das zunächst nur eine stabile Antwort auf eine sehr ähnliche Frage. Empfiehlt er ihn aber über unterschiedliche, stufentreue Fragen und wiederholte Gespräche hinweg, hängt die Empfehlung offenbar weniger von einer einzelnen Formulierung ab.
Für Top-3-Listen messen wir die Übereinstimmung mit dem Jaccard-Koeffizienten: gemeinsame Anbieter geteilt durch alle genannten Anbieter. {A, B, C} und {A, B, D} ergeben 2/4 = 0,5; identische Listen ergeben 1. Wir berechnen ihn getrennt:
zwischen Wiederholungen desselben Prompts beim selben Assistenten,
zwischen verschiedenen Prompts zum selben Produkt beim selben Assistenten,
je Anbieter: in wie vielen Prompts er in den Top 3 steht, bei wie vielen Assistenten in mindestens der Hälfte der Gespräche, und ob er in jeder Wiederholung oder nur gelegentlich genannt wird.
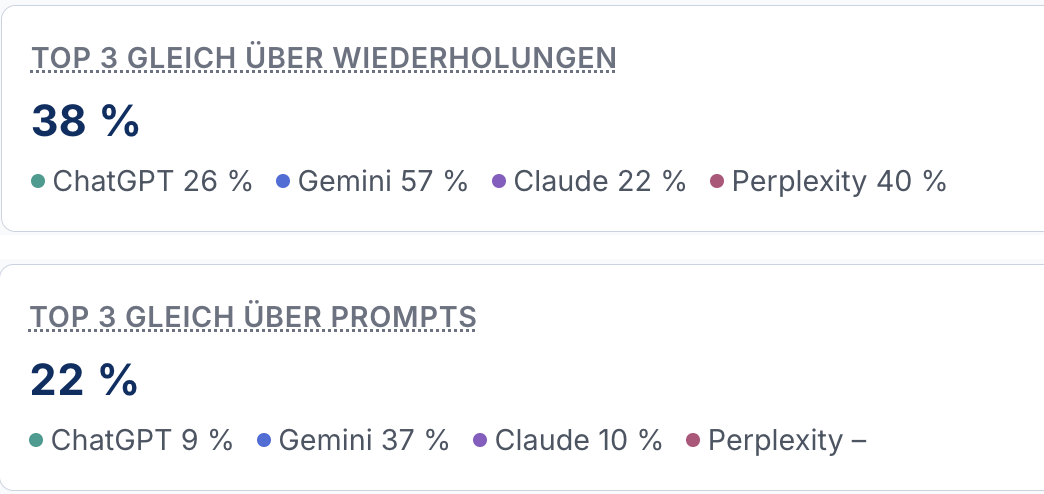
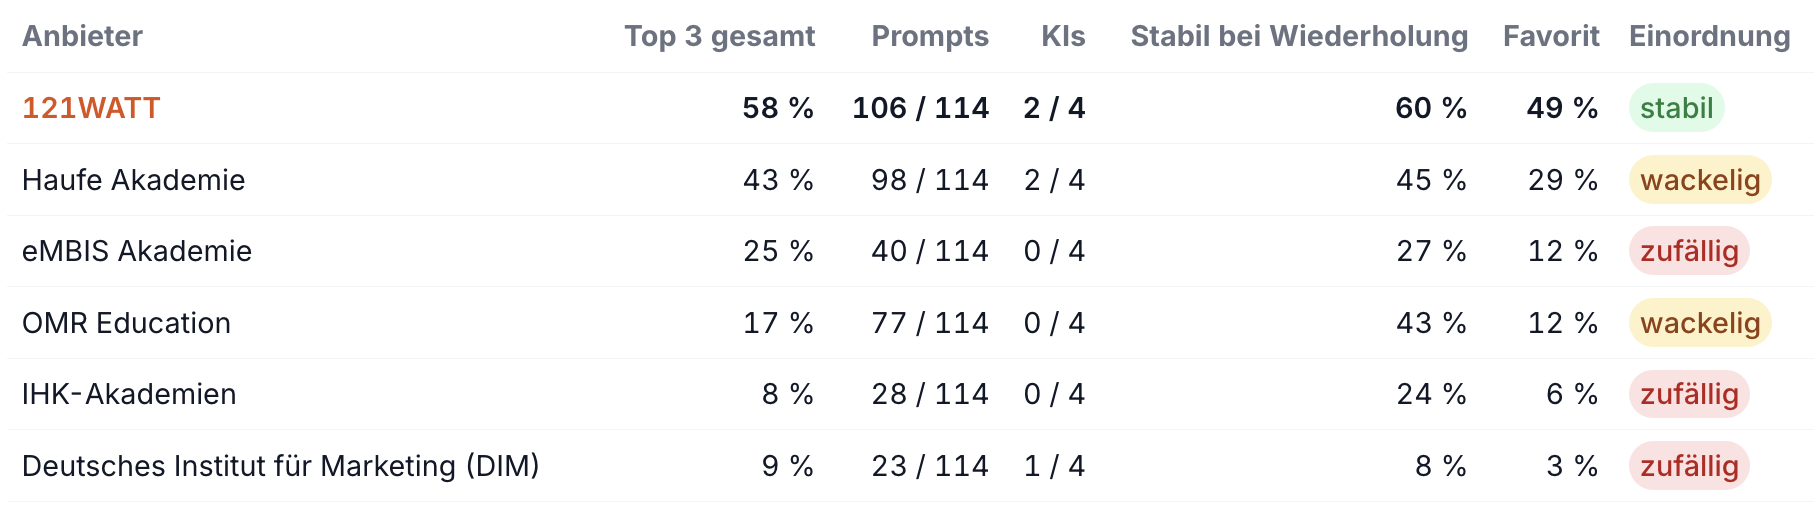
Abb. 4: Ausschnitt eines 121suite-Testlaufs – Ergebnis-Stabilität. Übereinstimmung der Top 3 über Wiederholungen und über Prompts, je Assistent, darunter die Einordnung je Anbieter.
Im Beispiel stimmen die Top 3 über Wiederholungen zu 38 % überein, über verschiedene Prompts nur zu 22 %. Die Formulierung hat also großes Gewicht. Trotzdem steht der führende Anbieter in 106 von 114 Prompts in den Top 3 – genau die Art Empfehlung, die nach unserer Schlussregel zur Aussagekraft eines Prompt-Sets auch für ungemessene Varianten spricht.
Unsere zentrale Hypothese: Je unterschiedlicher die Fragen innerhalb eines Kaufmotivs und je einheitlicher die Empfehlungen, desto robuster ist die Aussage, welchen Anbieter eine KI unter den getesteten Bedingungen bevorzugt. Eine Auswertung der Übereinstimmung je Framework-Stufe ist der naheliegende nächste Schritt.
Das erlaubt eine gut begründete Aussage über die Empfehlungsstabilität im untersuchten Panel. Es erlaubt keine Aussage wie „Mit 85 % Wahrscheinlichkeit bekommt jeder echte Nutzer diesen Anbieter empfohlen“. Dafür müssten wir wissen, wie reale Nutzer ihre Fragen verteilen und welche Kontexte sie mitbringen.
Konstruierte Prompts. Sie sind keine repräsentative Stichprobe echter Nutzeranfragen. Belastbare Volumina realer Kauf-Prompts gibt es bislang nicht.
API ist nicht Consumer-App. Systemanweisungen, Personalisierung, Gedächtnis und Standort können sich unterscheiden. Wir modellieren einen neutralen Nutzer ohne Vorgeschichte.
Modellwechsel verändern das Messinstrument. Ein Sprung im Index kann technische statt marktseitige Ursachen haben.
Kodierung durch ein Modell. Der Abgleich mit der Gesprächszusammenfassung deckt Differenzen auf, verhindert aber keine Fehlklassifikationen.
Stichprobengröße. Vier Assistenten, mehrere Wiederholungen und ein Dutzend Prompts ergeben je Produkt weit über hundert Gespräche. Das macht deutliche Unterschiede sichtbar, nicht beliebig kleine.
Viele Vergleiche. Anbieter × KIs × Produkte ergeben viele Tests. Bei echter Gleichheit erscheint etwa jeder zwanzigste zufällig als „vorn“ oder „dahinter“. Einzelne Zellen sind mit Vorsicht zu lesen.
Gemittelte Quoten, gepoolte Fallzahl. Die Quoten mitteln wir über Produkte, n ist die Gesamtzahl der Antworten – eine Näherung.
Tokenverbrauch und Kosten. Jedes Gespräch besteht aus mehreren Fragen mit Websuche, und der Verlauf wächst mit jeder Stufe mit. Gerade die Websuche treibt die Zahl der verarbeiteten Token stark nach oben. Dazu kommen die Aufrufe für Auswertung und Prompt-Prüfung. Die Kosten wachsen linear mit Prompts, Assistenten und Wiederholungen, die Genauigkeit aber nur mit der Wurzel der Fallzahl: Für einen halb so großen Standardfehler braucht es viermal so viele Gespräche. Jede Messung ist deshalb ein Abwägen zwischen Genauigkeit und Budget.
Unser Zwischenfazit: Stufenpassung, Vielfalt, Wiederholungen und Stabilitätsanalysen machen die Messung nachvollziehbarer und robuster. Die statistische Unsicherheit zeigen wir trotzdem ausdrücklich – statt aus einem synthetischen Panel eine Gewissheit über das Verhalten aller Käufer zu machen.
Der Sichtbarkeitsindex sagt, ob ein Assistent empfiehlt. Ob daraus Geschäft entsteht, sagt er nicht. Dafür setzen wir auf ein Instrument, das wir seit Jahren nutzen: die Selbstauskunft der Kunden direkt nach dem Abschluss.
Warum nicht über Klickdaten? Eine KI-Empfehlung hinterlässt in der Webanalyse kaum eine eigene Spur. Wer bei ChatGPT von einem Anbieter liest, googelt ihn später oder tippt die Adresse direkt ein. In der Webanalyse erscheint das als Markensuche, Anzeige oder Direct-Zugriff – genau die Kanäle, die ohnehin viele andere Ursachen bündeln. Das haben wir schon 2019 gezeigt: In unserem Beitrag Digitale Werbeerfolgskontrolle: Wie messe ich eigentlich WoM und Cross-Channel-Effekte? gingen 74 % der Seminaranmeldungen, die die Webanalyse als „Direct“ zählte, laut Kunden auf Bestandskunden und Empfehlungen zurück. Selbst bei Anmeldungen über bezahlte Google-Anzeigen nannten nur 41 % Google als eigentlichen Auslöser. Die Webanalyse zeigt, woher jemand kommt, nicht warum.
Wie wir fragen. Das Vorgehen übertragen wir auf GEO:
Zeitpunkt: direkt nach dem Abschluss, auf der Danke- oder Bestätigungsseite. Im B2B-Geschäft auch im Anmeldeformular oder im ersten Vertriebsgespräch.
Frage: nach dem Auslöser, nicht nach dem Kanal – sinngemäß „Was hat dich auf uns gebracht?“.
Antworten: geschlossene Optionen, die zum Geschäftsmodell passen, mit einer eigenen Option „Empfehlung eines KI-Assistenten (z. B. ChatGPT, Gemini, Claude, Perplexity)“ getrennt von „Google-Suche“ und „Empfehlung von Kollegen oder Freunden“.
Verzerrungen dämpfen: Reihenfolge der Optionen bei jedem Aufruf zufällig, eine offene Option „etwas anderes“ und eine Scheinoption, die niemand ernsthaft wählen kann. Wer sie anklickt, klickt zufällig – diese Antworten rechnen wir heraus.
Wie wir es mit dem Index verbinden. Wir verfolgen den Anteil „KI-Assistent“ Monat für Monat, wenn möglich je Produkt, und legen ihn neben den Sichtbarkeitsindex aus demselben Monat. Steigen beide gemeinsam, ist das ein Hinweis, kein Kausalnachweis. Wer eine Maßnahme nach wenigen Tagen bewertet, misst eher Schwankungen als Effekte; der monatliche Turnus passt deshalb zu beiden Messungen.
Grenzen der Selbstauskunft. Sie erfasst nur bewusste, erinnerte Einflüsse. Bei wenigen Abschlüssen kommen zu wenige Antworten zusammen. Und Menschen antworten gern so, wie es klug klingt – genau das ist Rand Fishkins zentraler Einwand gegen Befragungen – „ChatGPT“ kann in Befragungen deshalb über- wie untertrieben sein. Zufallsreihenfolge, Scheinoption und die offenen Antworten helfen, solche Effekte zu erkennen. Wir werten deshalb vor allem die Entwicklung des Anteils über die Monate aus, nicht seine absolute Höhe. Trotzdem ist die Selbstauskunft heute der direkteste Weg, den Geschäftseffekt einer KI-Empfehlung überhaupt zu sehen.
GEO-Sichtbarkeit ist keine feste Google-Position. Sie verändert sich mit der Frage, dem Gesprächsverlauf und dem Modell. Für eine sinnvolle Messung brauchen wir deshalb nicht einen Prompt und eine Markenzählung, sondern eine nachvollziehbare Stichprobe, standardisierte Gesprächsstufen, Wiederholungen und transparente Auswertungsregeln.
Unsere wichtigsten Entscheidungen waren:
Produkte statt nur Marken messen.
Kaufgespräche statt isolierter Einzelfragen analysieren.
Prompts vor dem Einsatz systematisch auf Passung und Vielfalt prüfen.
Empfehlungen immer mit ihren Quellen und Auswahlkriterien betrachten.
Den Geschäftseffekt nicht aus Klicks ableiten, sondern die Kunden fragen.
Damit lässt sich deutlich besser erkennen, wo Angebote im KI-gestützten Auswahlprozess stehen und welche Maßnahmen sich lohnen könnten. Die Messung ist aber keine absolute Wahrheit über echtes Nutzerverhalten und erst recht kein Ersatz für Geschäftszahlen. Ob GEO eine Ablenkung ist, entscheidet am Ende nicht der Traffic, sondern die Antwort der Kunden auf die Frage, was sie zu uns gebracht hat.
Uns interessiert eure Meinung: Wie messt ihr Empfehlungen in KI-Assistenten? Und wo seht ihr die größten methodischen Grenzen? Wir freuen uns auf eure Erfahrungen.
Info: Die 121suite und die 121 Apps GmbH
Die 121suite.com (derzeit in der Closed Beta) ist eine Marketing-Plattform, die SEO-, Paid- und GEO-Daten in einer Anwendung zusammenführt. Ihr Kern ist die hier beschriebene Messung, wie sichtbar Produkte und Leistungen in ChatGPT, Gemini, Claude und Perplexity sind: simulierte Kaufgespräche, geprüfte Prompts, Quellen- und Wettbewerbsanalyse, jeweils in der Sprache und mit der Websuche des Zielmarkts.
Wir entwickeln die 121suite im Rahmen der 121 Apps GmbH, zusammen mit weiteren Produkten zu Themen, die uns beschäftigen:
121surveys.com – Online-Umfragen (gelauncht)
paperball.finance – ETF-Backtests, Monte-Carlo-Simulationen und Wertpapier-Watchlists (gelauncht), Teil der Produktfamilie paperball.de
121suite.com – Marketing-Plattform mit GEO-Sichtbarkeitsmessung (derzeit in der Closed Beta)
121assist.com – KI-gestützte RAG-Chatsysteme für Kundensupport und Wissensvermittlung (derzeit in der Closed Beta)
Mehr über uns und alle Produkte: 121apps.com
Rand Fishkin: #5minutewhiteboard – Is AI visibility a boondoggle? A sham? A distraction? (LinkedIn, Oktober 2026, mit Diskussion)
Marie Haynes: GEO is a Distraction
The SEO Works: AI Referral Traffic Benchmark
Kevin Indig: Does AI drive more direct traffic?
Michael King: AI Search Is Not a Distraction, It’s a Branding Channel
Christian Kunz: Warum wenig KI-Traffic kein Argument gegen GEO ist
Christoph Röck: Digitale Werbeerfolgskontrolle: Wie messe ich eigentlich WoM und Cross-Channel-Effekte? (121WATT, 2019)
Deine Stimme entscheidet mit, welche Themen wir als Nächstes vertiefen.
Optional, aber Gold wert für unsere Redaktion.
Danke, du hast dieser Artikel bereits bewertet.

 089 416126990