
 Autor:in
Alex Stöckl
Du kannst dir 121WATT-Inhalte in der Google-Suche jetzt bevorzugt anzeigen lassen.
Du willst in Claude schnell zehn Ad-Varianten gegenlesen lassen und stehst vor der Modellauswahl. Im Zweifel auf das stärkste Modell zu klicken fühlt sich vielleicht sicher an, verbraucht dein Nutzungskontingent aber unnötig schnell und die API-Kosten gehen bei den starken Modellen ebenfalls in die Höhe. Auf der anderen Seite willst du natürlich nicht das billigste Modell nehmen, nur um die Antwort aufwändig zu prüfen und nachzuarbeiten.
Hier erfährst du, welches Modell für welche Aufgaben das beste Preis-Leistungs-Verhältnis liefert.
Die aktuelle Claude-Reihe besteht aus Haiku 5.5, Sonnet 5.5, Opus 5.5 und Fable 5.1. Anthropic trainiert diese Modelle nicht für bestimmte Branchen oder Aufgabentypen. Ein eigenes „Marketing-Modell“ gibt es also nicht. Alle vier schreiben, recherchieren, analysieren und programmieren. Sie unterscheiden sich darin, wie schwierig eine Aufgabe sein darf, bevor das Modell unzuverlässig wird, und was diese Leistung an Zeit und Geld kostet. Alle vier verarbeiten bis zu einer Million Token Kontext und haben einen Wissensstand bis Juni 2026. Für aktuelle Entwicklungen brauchst du also bei jedem Modell die Websuche.
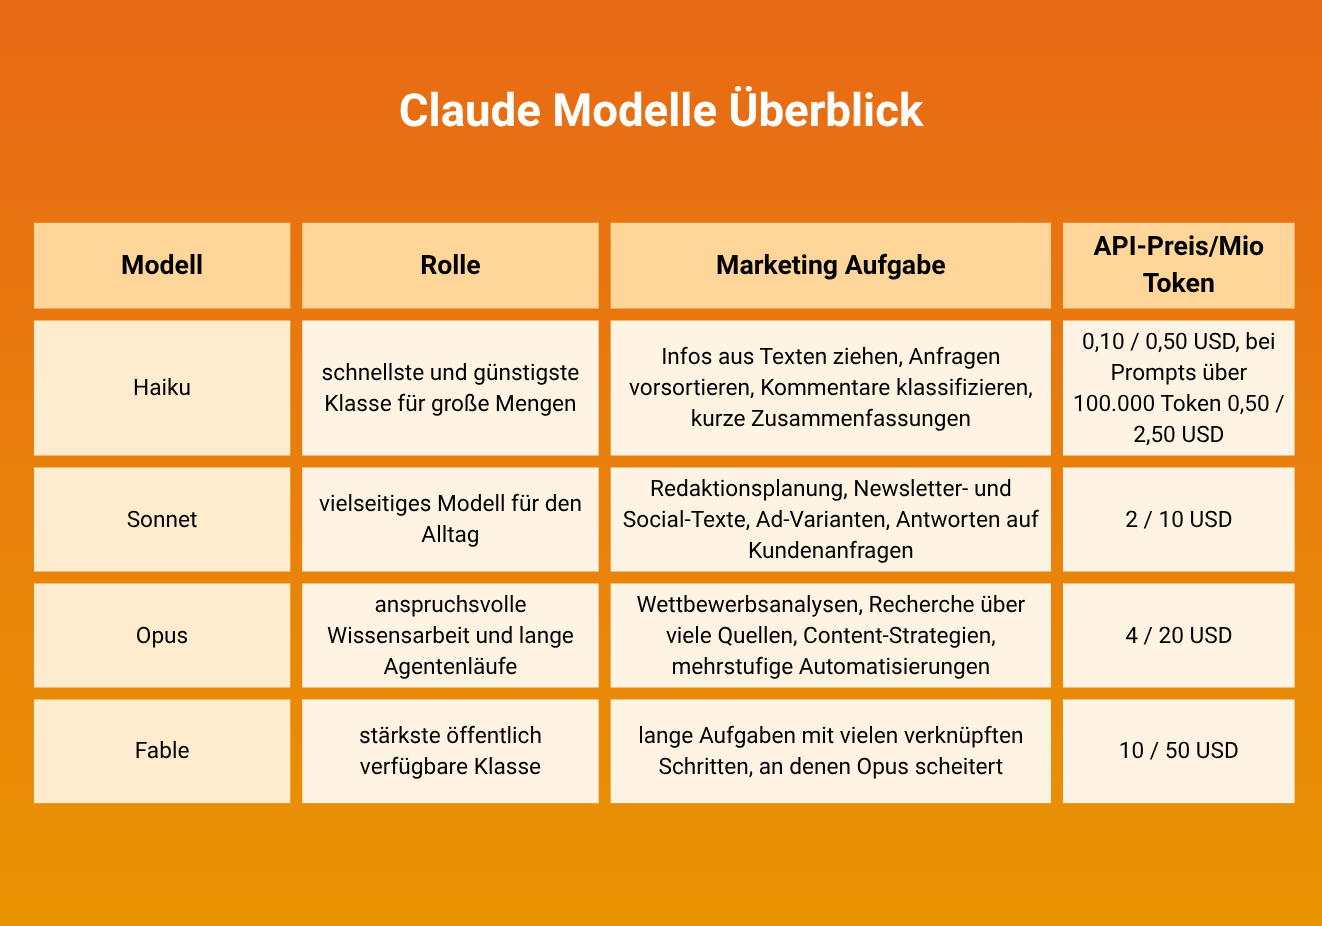
Welches Modell passt, hängt weniger vom Thema ab als von vier Eigenschaften der Aufgabe: Wie oft fällt sie an? Wie komplex ist sie? Was kostet ein Fehler? Und wie gut muss das Ergebnis ohne Nacharbeit sein?
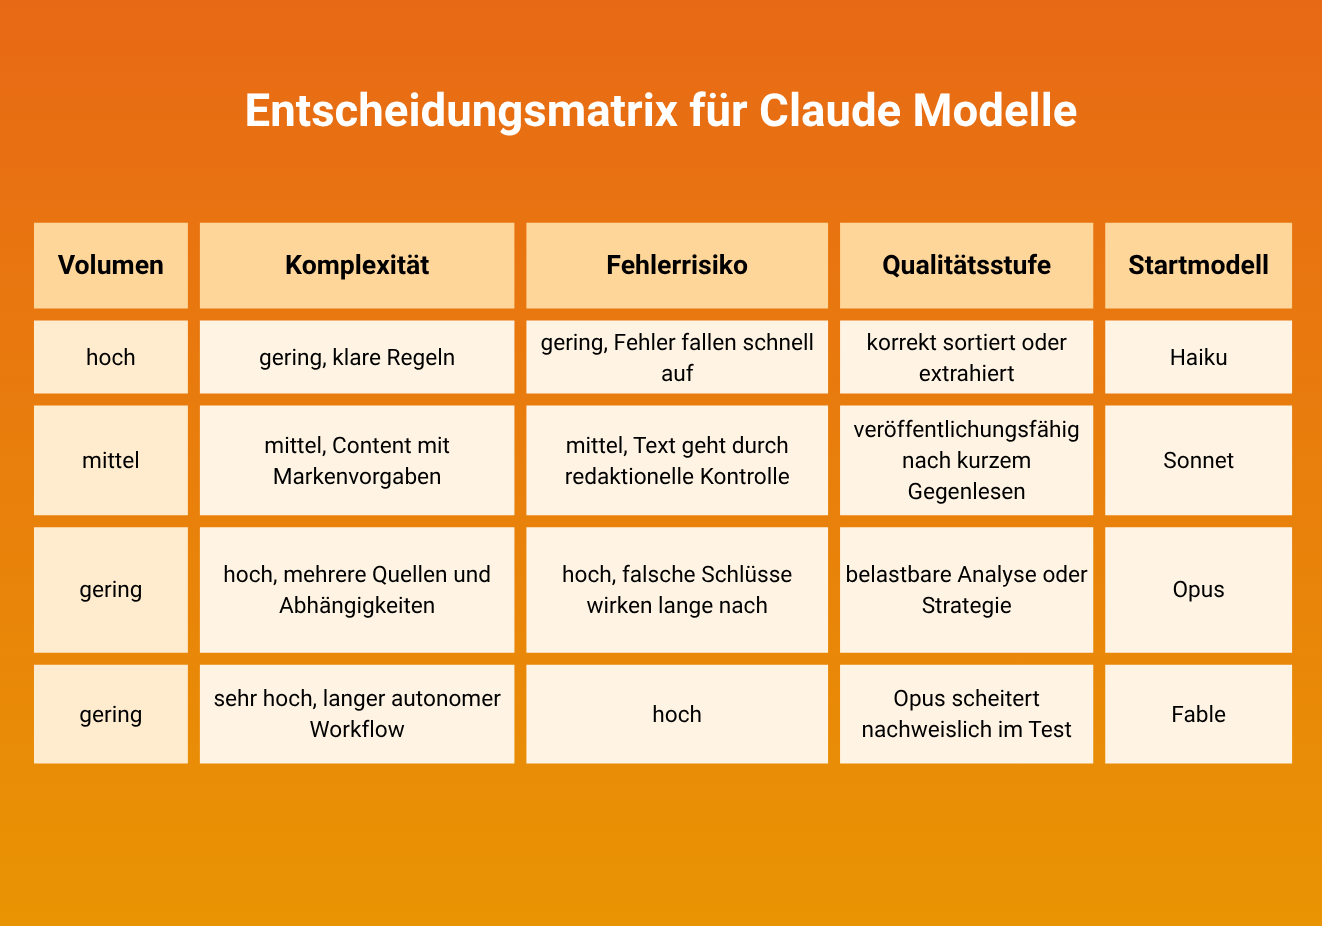
Ein Beispiel aus dem Marketing-Alltag:
Anthropic beschreibt zwei sinnvolle Startpunkte. Für einfache, volumenstarke Aufgaben kannst du mit Haiku beginnen und bei Qualitätsproblemen hochstufen. Bei komplexen Aufgaben startest du mit Opus, optimierst Prompt und Effort (die einstellbare Denkstufe) und wechselst erst bei nachgewiesenen Grenzen zu Fable.
Für den zweiten Weg spricht ein Argument, das im Marketing-Alltag oft übersehen wird. Stärkere Modelle brauchen häufig weniger Anläufe, bis ein Ergebnis stimmt, und können deshalb pro erledigter Aufgabe günstiger sein. Außerdem gilt: Liefert ein kleines Modell ein schwaches SEO-Briefing, weißt du nicht, woran es liegt, am Modell, an deinem Prompt oder am fehlenden Kontext. Mit einem starken Modell als Ausgangspunkt trennst du solche Setup-Fehler sauber von Modellgrenzen.
Fable ist für anspruchsvolle, langfristige und mehrstufige Aufgaben gedacht. Für reine Textproduktion solltest du es erst einsetzen, wenn Opus in deinen eigenen Tests bei Qualität, Konsistenz oder Prozesslänge nicht ausreicht.
Pro-Tipp: Lass Claude selber entscheiden welches Modell er für welche Aufgabe nutzen soll: “(Deine Aufgabe) Hierfür sollst du in diesem Chat die Arbeit koordinieren und weitere Unterchats und Agents für Zusatzaufgaben einspannen um weniger Tokens zu verbrauchen und die Aufgaben sinnvoll zu verteilen.” Das funktioniert am besten über Claude Cowork oder Code.
Viele Marketer:innen nutzen Claude im Chat mit einem Pro-, Max- oder Team-Plan. Dort spielen Token-Preise keine direkte Rolle, wohl aber das Nutzungslimit und die Antwortzeit. Sarah-Yasmin Hennessen, Trainerin bei 121WATT, beschreibt ihren Umgang damit offen:
„Ich arbeite meistens mit Opus, weil mir mein Max-Plan ein hohes Nutzungslimit gibt und ich so das starke Modell für viele Aufgaben verwenden kann. Ich bin ehrlich, das ist meine Art zu arbeiten, aber nicht Best Practice. Grundsätzlich ist die Modellwahl eine Frage von Limit-Verbrauch und Geschwindigkeit: Je leistungsfähiger das Modell, desto mehr verbraucht es vom Kontingent und desto länger dauert die Antwort, deshalb lohnt sich ein kleineres Modell überall dort, wo es die Aufgabe genauso gut schafft. Meine Faustregel: Haiku für schnelle Sachen wie Informationen aus einem Text ziehen, etwas einordnen oder kurz zusammenfassen, Sonnet für einfachere Aufgaben wie Content planen, Opus für tiefe Recherche oder komplexere Tasks und Fable für lange Aufgaben mit vielen verknüpften Schritten.“
Ihre Faustregel deckt sich mit der Matrix oben. Gleichzeitig zeigt ihr Beispiel, wo die Regel endet: Mit großzügigem Limit kann Opus für fast alles die bequemste Wahl sein. Mit einem kleineren Plan kann genau diese Gewohnheit dazu führen, dass dir am Nachmittag das Kontingent fehlt, wenn die wirklich anspruchsvolle Analyse ansteht.
Sobald du Claude in Automatisierungen einbindest, etwa in n8n oder in eigene Tools, wird die Rechnung konkret. Für 5.000 Antworten auf Kundenanfragen mit Wissensbasis im Monat ergeben sich laut einer Beispielrechnung rund 4 Euro mit Haiku 5.5, rund 86 Euro mit Sonnet 5.5 und rund 172 Euro mit Opus 5.5. Das ist die Untergrenze, denn Denk-Token kommen als Ausgabe noch hinzu.
Die eigentliche Entscheidung fällt bei der Qualität. Kostet eine schwache Antwort zehn Minuten Nacharbeit bei 60 Euro Stundensatz, rechnet sich Sonnet gegenüber Haiku bereits, wenn es 1,6 von 1.000 Fehlantworten vermeidet. Zwei Details solltest du dabei kennen. Haiku 5.5 bleibt nur bei Prompts bis 100.000 Token so günstig, darüber kostet der gesamte Aufruf das Fünffache. Sehr lange Dokumente teilst du also besser in Abschnitte. Außerdem schmilzt der Preisvorteil von Sonnet, wenn du es auf die höchste Denkstufe stellst: Pro Aufgabe liegt es dann kaum noch unter Opus.
In Automatisierungen kannst du Modelle kombinieren. Ein Beispiel: Haiku sortiert eingehende Kundenanfragen, beantwortet die einfachen Fälle selbst und reicht die schwierigen zehn Prozent an Sonnet weiter. Diese Aufteilung kostet in der Beispielrechnung rund 2,70 Euro je 1.000 Vorgänge, also etwa ein Sechstel einer reinen Sonnet-Lösung.
Anthropic beschreibt einen zweiten Ansatz, die Advisor-Strategie. Dabei holt sich ein schnelleres Modell nur bei Bedarf Rat bei einem stärkeren Modell, etwa um einen Plan prüfen zu lassen. In einem Programmier-Benchmark kam Sonnet 5 mit Fable 5 als Berater bis auf zehn Prozent an das Ergebnis von Fable 5 heran, zu 63 Prozent der Kosten. Eine weitere Option wäre, dass ein stärkeres Modell viele Aufgaben koordiniert und diese nach Möglichkeit an schnellere Modelle auslagert.
Benchmarks helfen bei der groben Orientierung, doch die starken Modelle lösen dort inzwischen fast alle Aufgaben. Aussagekräftiger ist ein Test mit deinen eigenen Fällen.
Schritt 1: Eine wiederkehrende Aufgabe wählen. Nimm etwas, das du jede Woche erledigst und gut beurteilen kannst, zum Beispiel Meta Descriptions, Themenvorschläge für den Redaktionsplan oder Antworten auf Kommentare. Ordne sie mit der Matrix einem Startmodell zu.
Schritt 2: Echte Fälle durch mehrere Modelle schicken. Zehn reale Beispiele reichen für einen Schnelltest im Chat. Für produktive Automatisierungen hängt die nötige Stichprobe von der erwarteten Fehlerquote ab. Je seltener ein Fehler auftritt, desto mehr Fälle brauchst du, um ihn überhaupt zu sehen. Auch 200 Fälle sind keine Garantie, wenn schon einzelne Fehlantworten teuer oder riskant sind.
Schritt 3: Nacharbeit zählen. Bewerte nicht, ob der Text „gut klingt“. Miss, wie viel du korrigieren musstest und wie lange das gedauert hat.
Aufgabe: Wähle diese Woche eine Aufgabe, die du bisher mit Opus erledigst, und lass sie parallel von Sonnet bearbeiten. Ist die Nacharbeit gleich, hast du ein Stück Kontingent oder Budget gewonnen.
Nimm das kleinste Modell, das deine Qualitätsgrenze zuverlässig erreicht. Starte bei klaren Massenaufgaben mit Haiku, im Content-Alltag mit Sonnet und bei komplexen Analysen mit Opus. Fable kommt erst ins Spiel, wenn Opus trotz sauberem Prompt und höherem Effort nachweislich nicht reicht. Im Abo sparst du damit Kontingent und Wartezeit, über die API vor allem Nacharbeit.
Wenn du Claude über die Modellwahl hinaus sicher im Arbeitsalltag einsetzen willst, ist unser Claude-Seminar der passende nächste Schritt.
Quellen: Claude by Anthropic, Anthropic Docs, Collective Brain
Hat dir der Artikel gefallen? Dann lass uns gerne eine Bewertung oder einen Kommentar da.
Dieser Artikel wurde KI-unterstützt erstellt und durch menschliche Fachkenntnis überarbeitet und optimiert..
Deine Stimme entscheidet mit, welche Themen wir als Nächstes vertiefen.
Optional, aber Gold wert für unsere Redaktion.
Danke, du hast dieser Artikel bereits bewertet.

 089 416126990
